Instance segmentation YOLOv8 mendeteksi piksel tiap objek secara presisi, beda dari bounding box biasa.
Mempelajari instance segmentation menggunakan YOLOv8-seg untuk menggabungkan deteksi objek dan segmentasi piksel secara akurat.
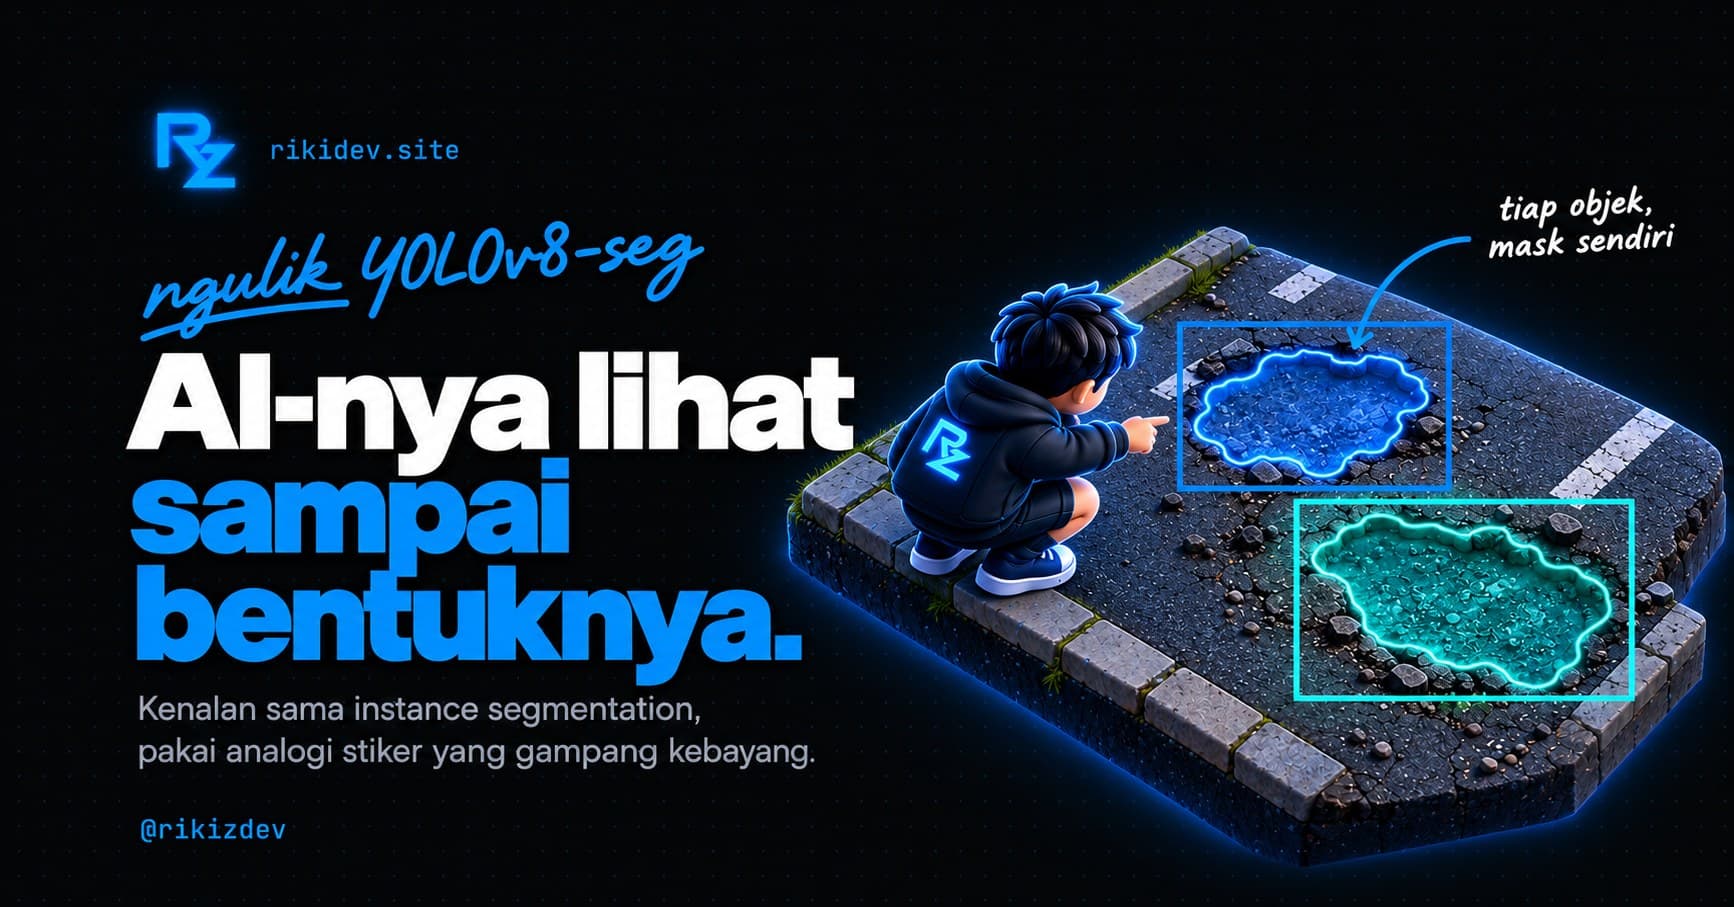
Beberapa waktu lalu aku mendalami materi tentang computer vision, khususnya instance segmentation dari AI Super Class. Kalau sebelumnya kita mengenal semantic segmentation dan object detection secara terpisah, kali ini keduanya digabungkan. Instance segmentation bertugas memetakan piksel tiap objek secara terpisah, bukan sekadar melabeli per kelas atau membuat kotak pembatas. Model seperti YOLOv8-seg menjadi salah satu alat utama untuk melakukan tugas ini karena mampu mengeluarkan koordinat kotak sekaligus masker pikselnya dalam satu proses.
#Menggabungkan Deteksi dan Segmentasi
Dalam pembelajarannya, instance segmentation berada di persimpangan antara semantic segmentation dan object detection. Semantic segmentation bekerja pada tingkat kelas, di mana seluruh piksel dari kelas yang sama disatukan tanpa memedulikan individu objeknya. Sebaliknya, object detection fokus pada kotak pembatas atau bounding box. Ketika digabungkan, model tidak hanya tahu di mana letak suatu benda, tetapi juga batas pasti dari setiap individu benda tersebut menggunakan masker atau mask. Perkembangan ini juga didukung oleh pemahaman tentang evolusi model dari YOLOv1 yang memakai label encoding grid dengan angka nyata, penggunaan anchor sejak YOLOv2 untuk mengatasi batasan kotak, pemanfaatan Feature Pyramid Network atau FPN untuk objek kecil, hingga arsitektur Mask R-CNN yang mengandalkan multi-task learning dengan satu backbone dan banyak head. Kita juga bisa melihat kapan harus memilih model deteksi atau segmentasi berdasarkan tabel keputusan yang ada.
#Tantangan Membaca Mask dan Boxes di YOLOv8
Saat menggunakan YOLOv8-seg, model akan menghasilkan keluaran berupa koordinat kotak atau boxes sekaligus masker piksel atau masks. Tantangan terbesar yang sering ditemui saat praktik bukanlah sekadar menjalankan modelnya, melainkan cara membaca mask dan boxes tersebut dengan benar. Kita harus memperhatikan parameter confidence atau conf serta teknik pengolahan seperti NMS atau Non-Maximum Suppression untuk membuang kotak kembar. Jika tidak hati-hati, cara membaca hasil keluaran ini bisa membuat jumlah objek tidak terhitung secara akurat atau mengalami duplikasi data.
#Pengalaman Lapangan dan Kebutuhan Proyek
Materi belajar ini juga mencakup berbagai kebutuhan nyata di luar teori slide yang sering ditemui saat proyek sungguhan. Beberapa di antaranya meliputi cara membaca stream CCTV menggunakan format M3U8 atau RTSP, menyimpan hasil rekaman, membuat virtual line, hingga melakukan tracking agar objek memiliki ID yang tetap antar frame. Selain itu, aspek deployment ke perangkat edge seperti mini PC menggunakan format ONNX, TensorRT, atau OpenVINO menjadi kunci agar model dapat berjalan secara on-premise dengan presisi yang terjaga. Pendekatan data-centric juga ditekankan melalui analisis siklus low-confidence dan augmentasi untuk memperbaiki akurasi model.
#Penutup
Mempelajari instance segmentation membuka wawasan baru tentang bagaimana komputer melihat dunia secara lebih rinci. Kombinasi antara pemahaman konsep dasar, praktik YOLOv8-seg, dan pengalaman lapangan membuat penerapan computer vision menjadi lebih terarah. Dengan mengenali batasan model serta tantangan pembacaan mask, kita bisa membangun sistem yang lebih handal untuk berbagai kebutuhan proyek nyata di masa mendatang.