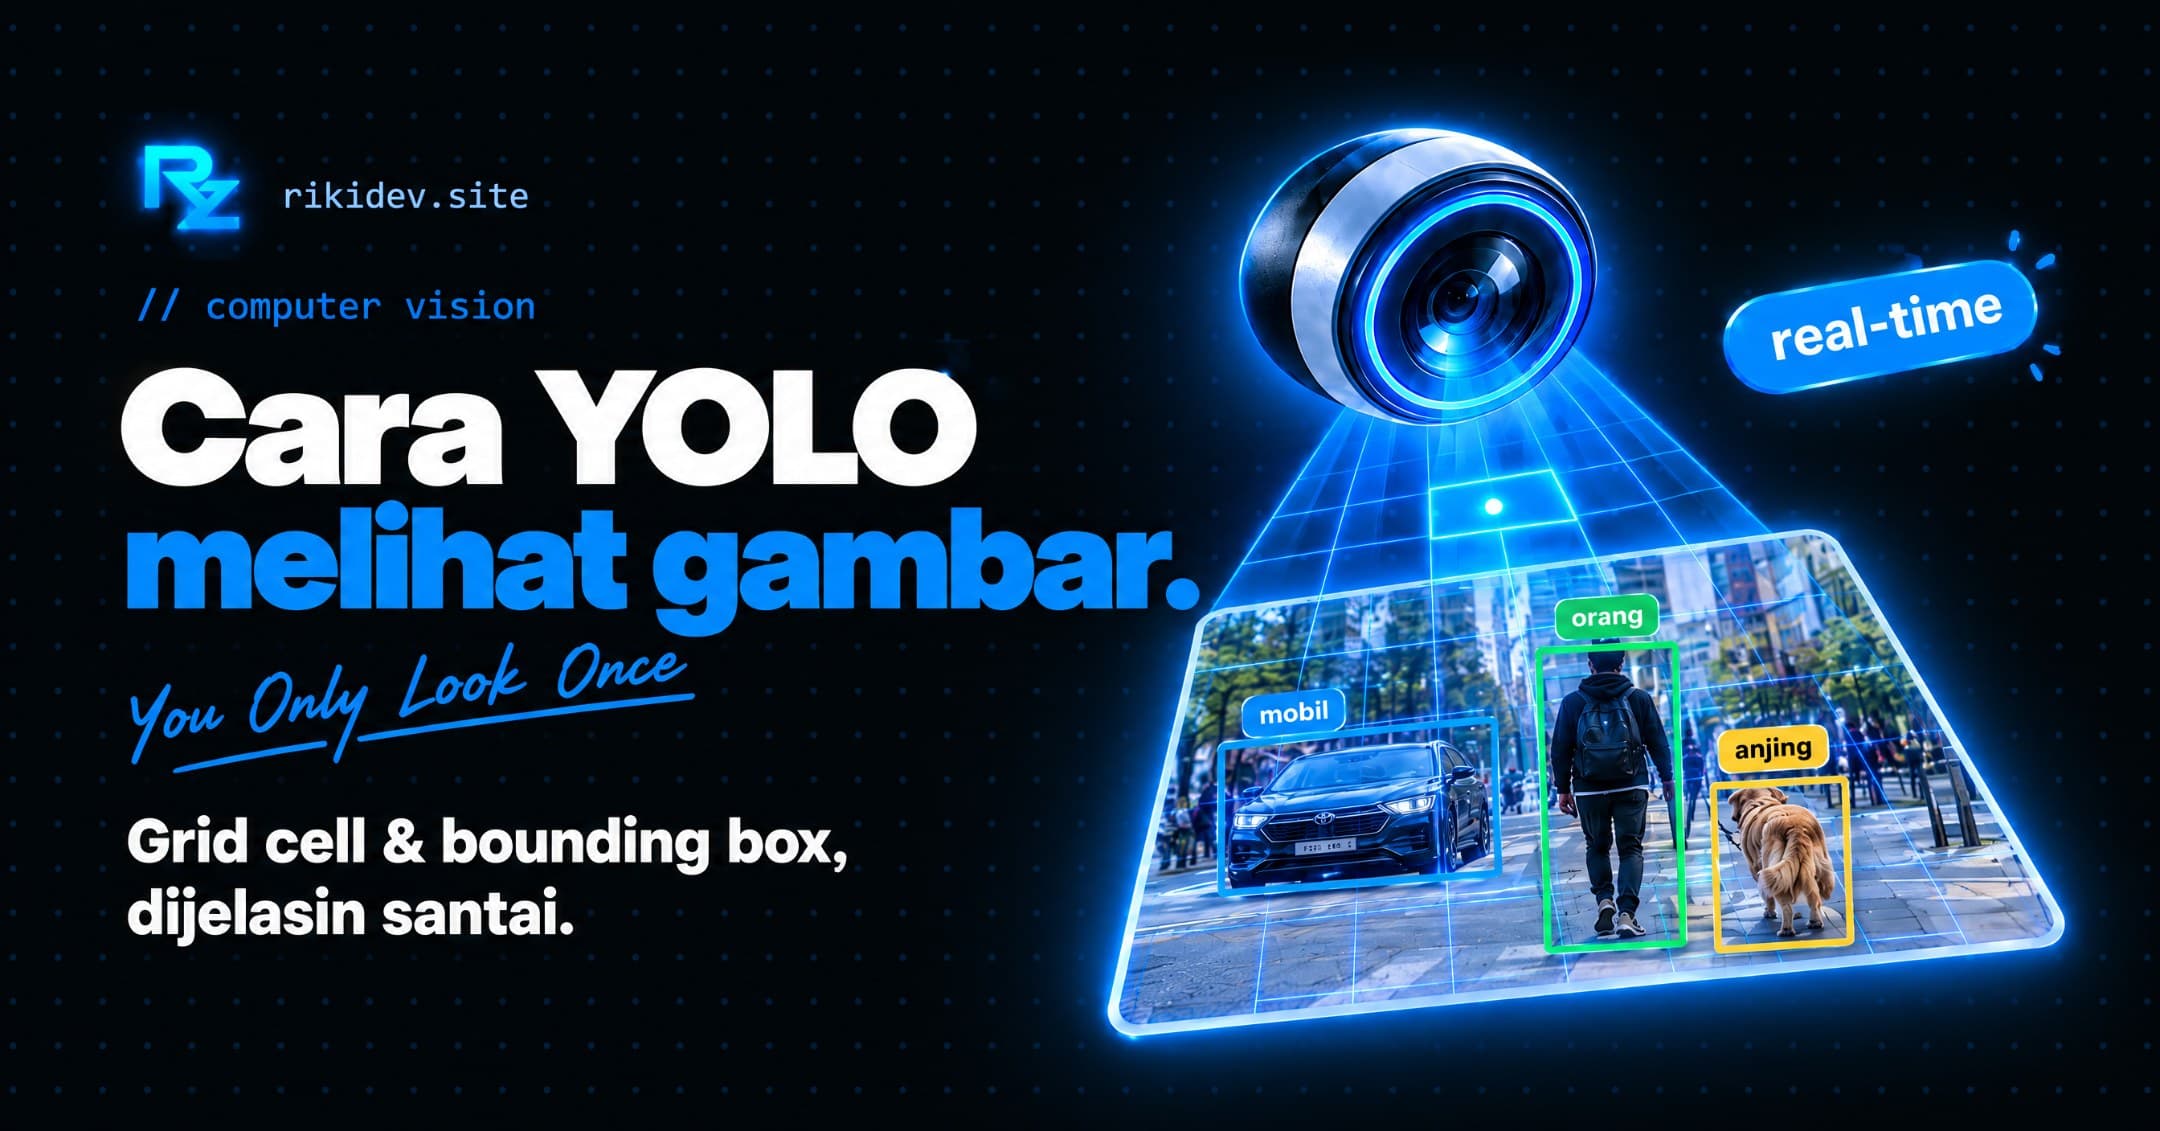
YOLO memproses gambar dalam satu forward pass lewat grid 7x7 tanpa Region Proposal Network.
Penjelasan mengenai cara kerja arsitektur one-stage YOLO, pembagian grid cell, dan prediksi bounding box untuk deteksi objek real-time.
Object detection bukan sekadar mengenali gambar apa yang ada di layar, melainkan juga mencari tahu di mana tepatnya posisi objek tersebut. Berbeda dengan klasifikasi biasa yang hanya memberikan satu label per gambar, object detection menghasilkan banyak bounding box lengkap dengan label dan skor kepercayaannya. Saat mendalami materi computer vision ini, salah satu arsitektur yang paling menarik untuk dibahas adalah YOLO.
#Konsep One-Stage pada YOLO
Nama YOLO merupakan singkatan dari You Only Look Once. Artinya, gambar dilewatkan ke dalam model hanya satu kali saja. Pendekatan ini berbeda jauh dengan model two-stage seperti Faster R-CNN yang masih menggunakan Region Proposal Network atau RPN. Pada model two-stage, proses dibagi menjadi dua tahap yaitu mencari kandidat area terlebih dahulu, lalu melakukan regresi kotak dan klasifikasi untuk setiap kandidat secara satu persatu. Hal tersebut membuat waktu prosesnya menjadi lebih lambat.
Sebaliknya, model one-stage seperti YOLO menyelesaikan semuanya dalam satu kali forward pass. Fitur, lokasi, dan kelas diproses secara bersamaan. Meskipun harus mengorbankan sedikit akurasi pada objek yang sangat kecil dibandingkan model two-stage, kecepatan YOLO jauh lebih unggul dan sangat cocok digunakan untuk kebutuhan produksi seperti kamera pengawas atau analisis video secara langsung.
#Peran Grid Cell dalam Pemrosesan Gambar
Salah satu konsep yang paling sering disalahpahami adalah cara pembagian grid pada gambar. Pada versi awalnya, YOLO menggunakan grid berukuran 7 kali 7 sehingga terdapat 49 sel. Penting untuk diingat bahwa gambar sebenarnya tidak benar-benar dipotong menjadi 49 bagian secara fisik. Gambar tetap diproses secara utuh oleh convolutional neural network.
Grid ini sebenarnya hanya muncul pada saat data loading, di mana label ground truth diubah ke koordinat grid, serta saat membaca output model yang berbentuk array 3D. Angka 7 kali 7 tersebut didapatkan dari ukuran feature map setelah melewati backbone CNN yang memperkecil ukuran gambar secara total.
#Tugas Setiap Sel dalam Memprediksi Objek
Setiap sel yang ada pada grid memiliki tanggung jawab yang spesifik untuk menebak kondisi di wilayahnya sendiri. Ketika sebuah objek muncul, sel yang memuat titik tengah dari objek tersebutlah yang akan bertugas untuk memprediksinya. Secara rinci, setiap sel harus menjawab beberapa pertanyaan penting terkait objek.
Pertanyaan pertama adalah apakah terdapat objek di sel tersebut yang direpresentasikan oleh nilai keandalan atau objectness. Pertanyaan kedua adalah mengenai posisi bounding box yang terdiri dari empat angka yaitu koordinat titik tengah serta ukuran lebar dan tinggi kotak. Pertanyaan terakhir adalah probabilitas kelas dari objek tersebut.
#Penutup
Memahami bagaimana grid cell dan bounding box bekerja memberikan gambaran yang jelas mengapa YOLO mampu melakukan deteksi objek dengan sangat cepat. Dengan membuang proses usulan wilayah dan mengandalkan satu lintasan grid, model ini dapat diandalkan untuk berbagai kebutuhan aplikasi real-time.