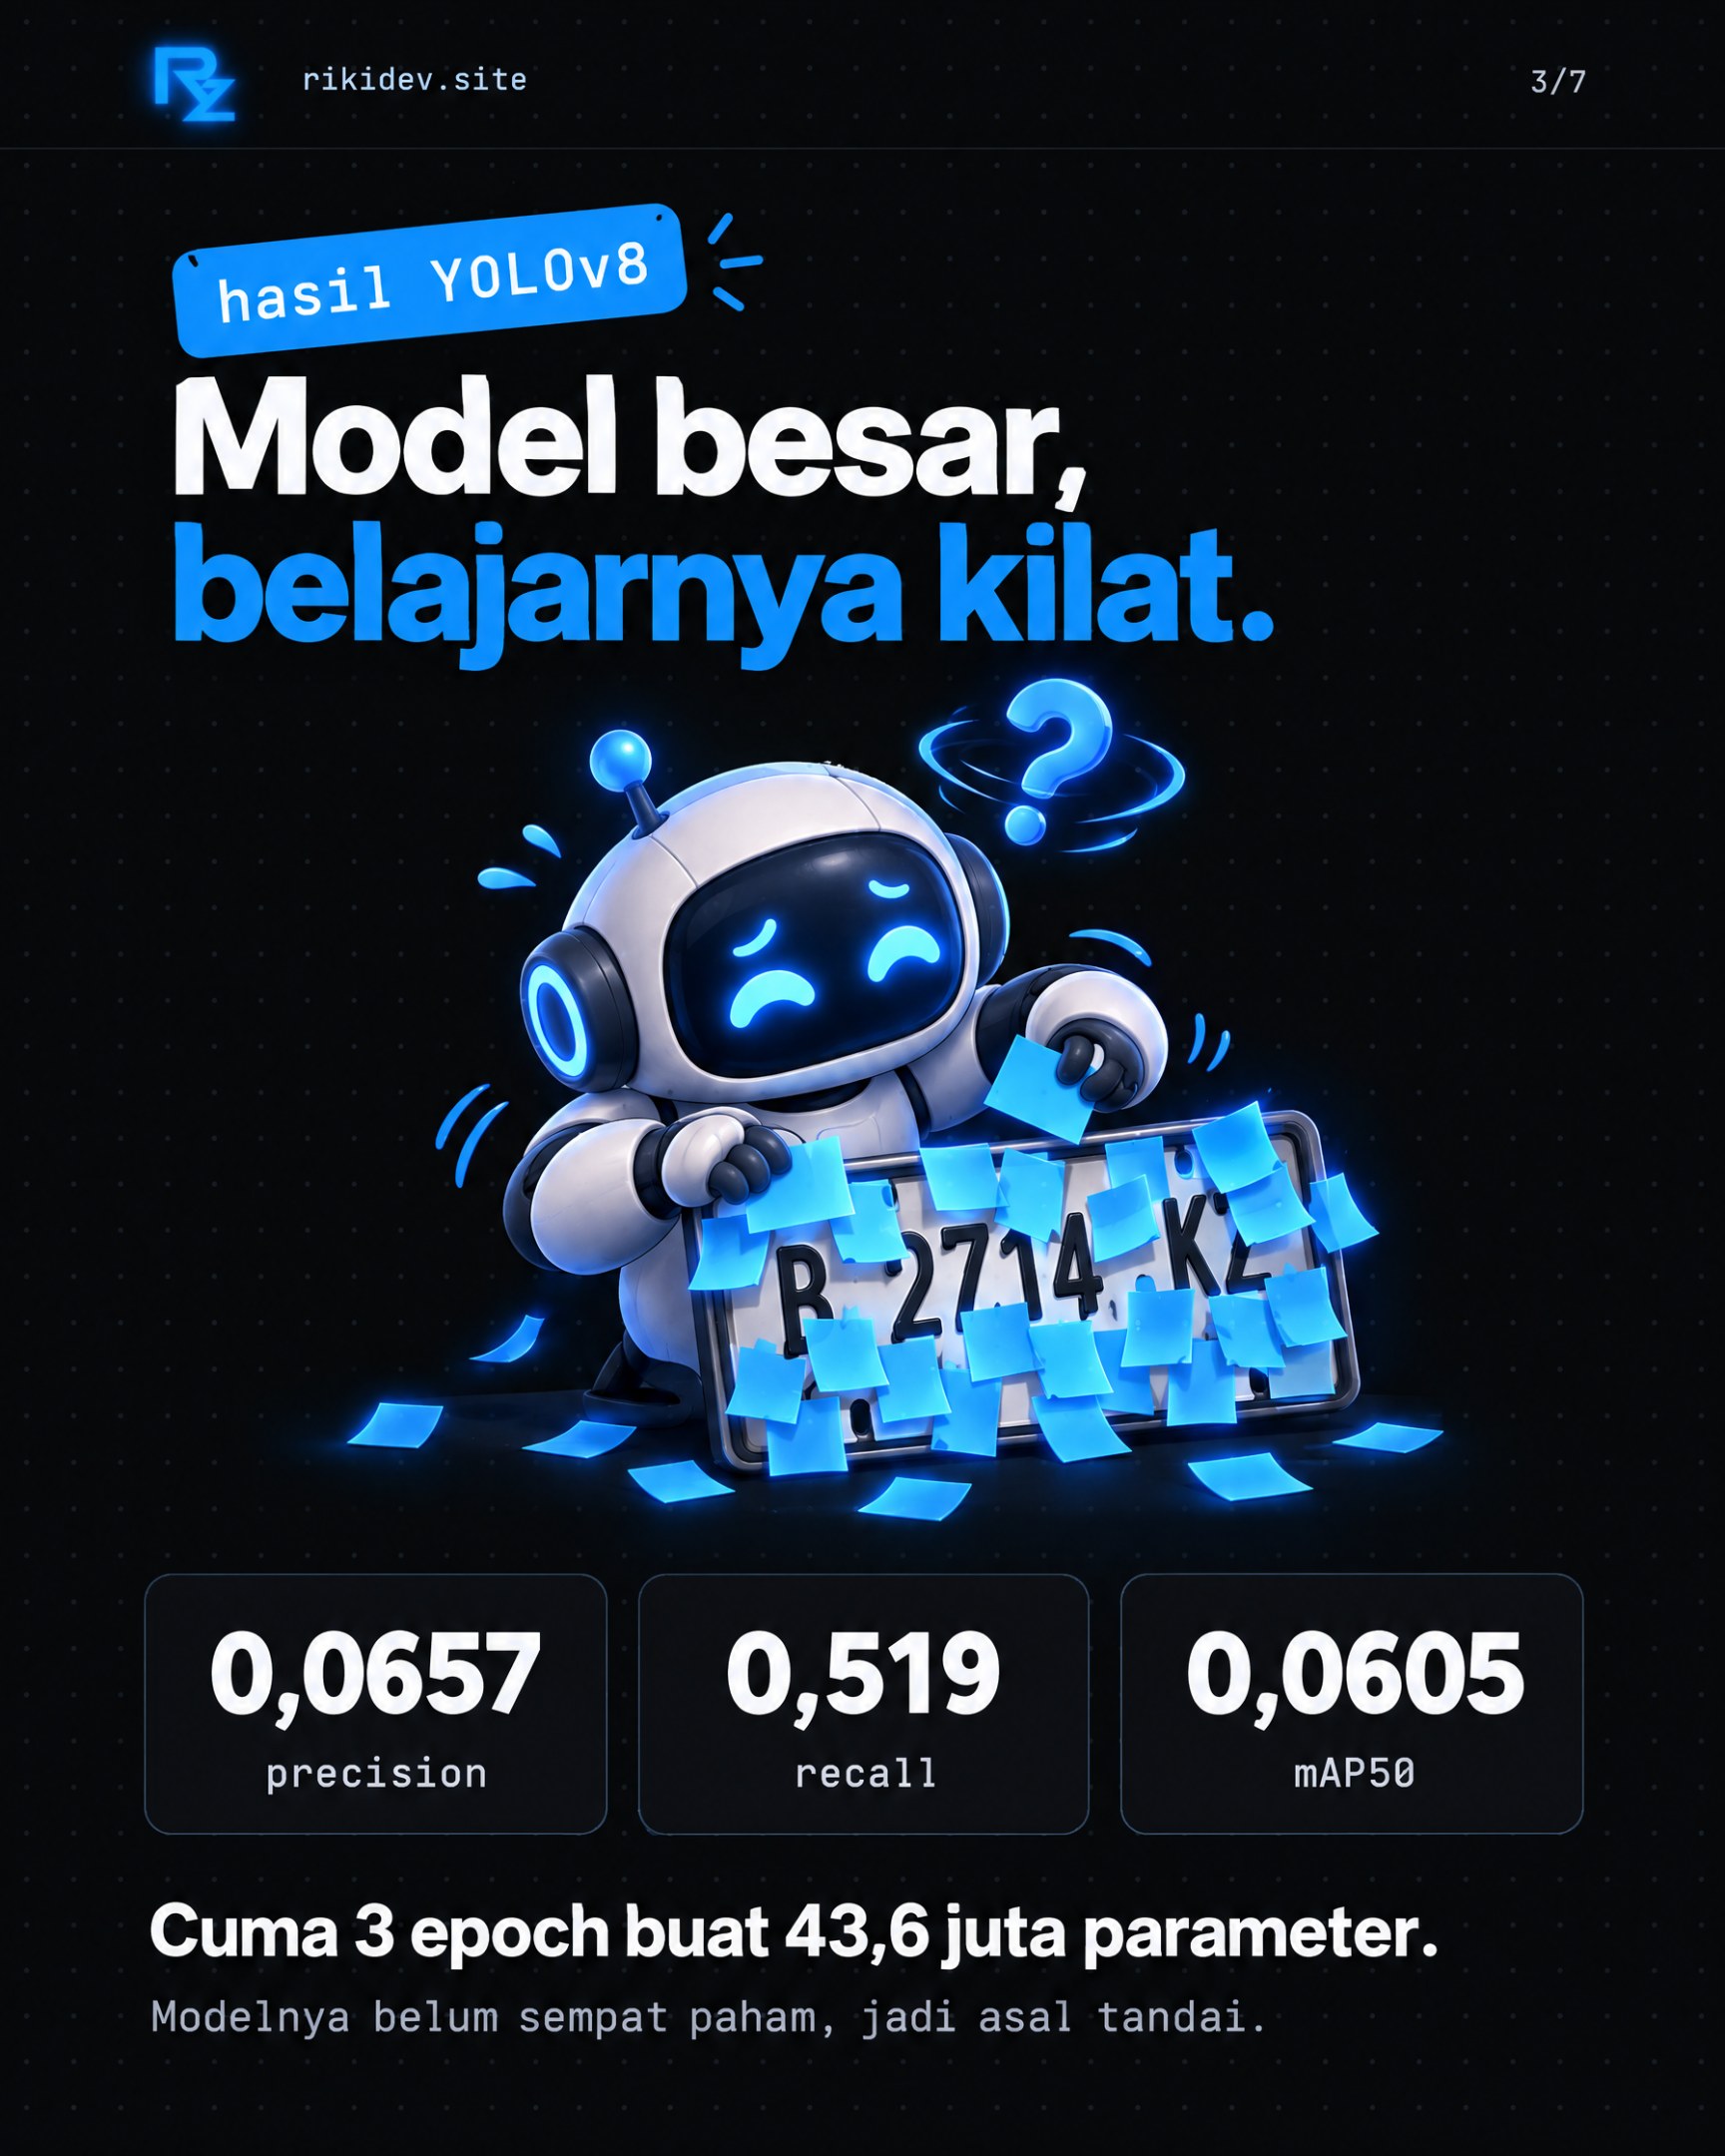
Latih YOLOv8l 3 epoch dengan 277 gambar plat nomor, hasilnya 31 kotak per gambar karena undertrained.
Eksperimen membandingkan YOLOv8 dan CNN dari nol untuk deteksi plat nomor menggunakan dataset kecil dari Roboflow.
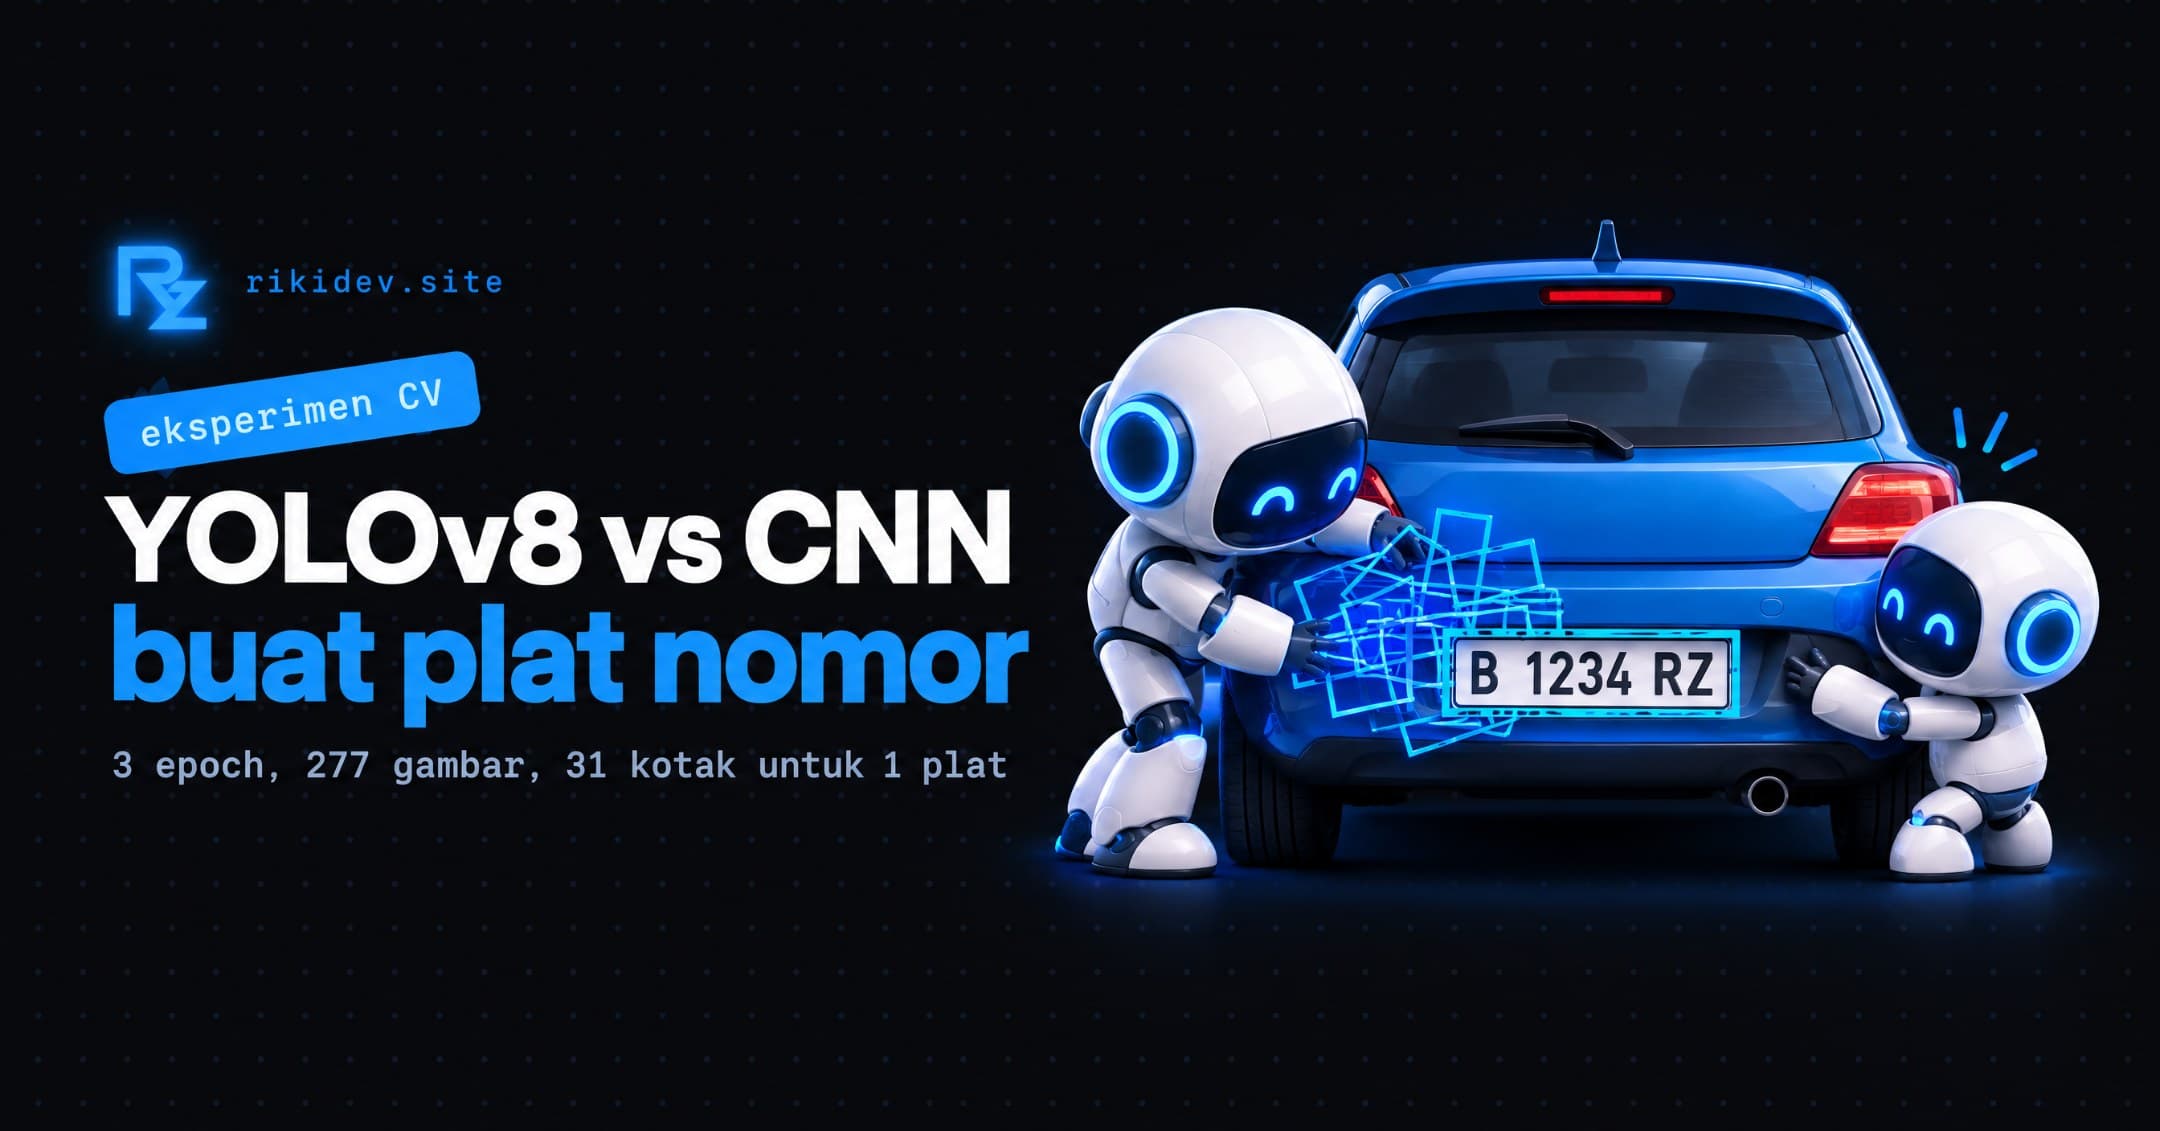
Aku mencoba eksperimen menarik untuk deteksi plat nomor kendaraan menggunakan dataset kecil dari Roboflow. Kasus ini aku kerjakan dengan dua cara berbeda, yaitu memakai model siap pakai YOLOv8 dan membuat model Convolutional Neural Network sendiri dari nol untuk melihat bagaimana performa keduanya dalam mendeteksi plat nomor.
#Mengenal Dataset dan Struktur Label
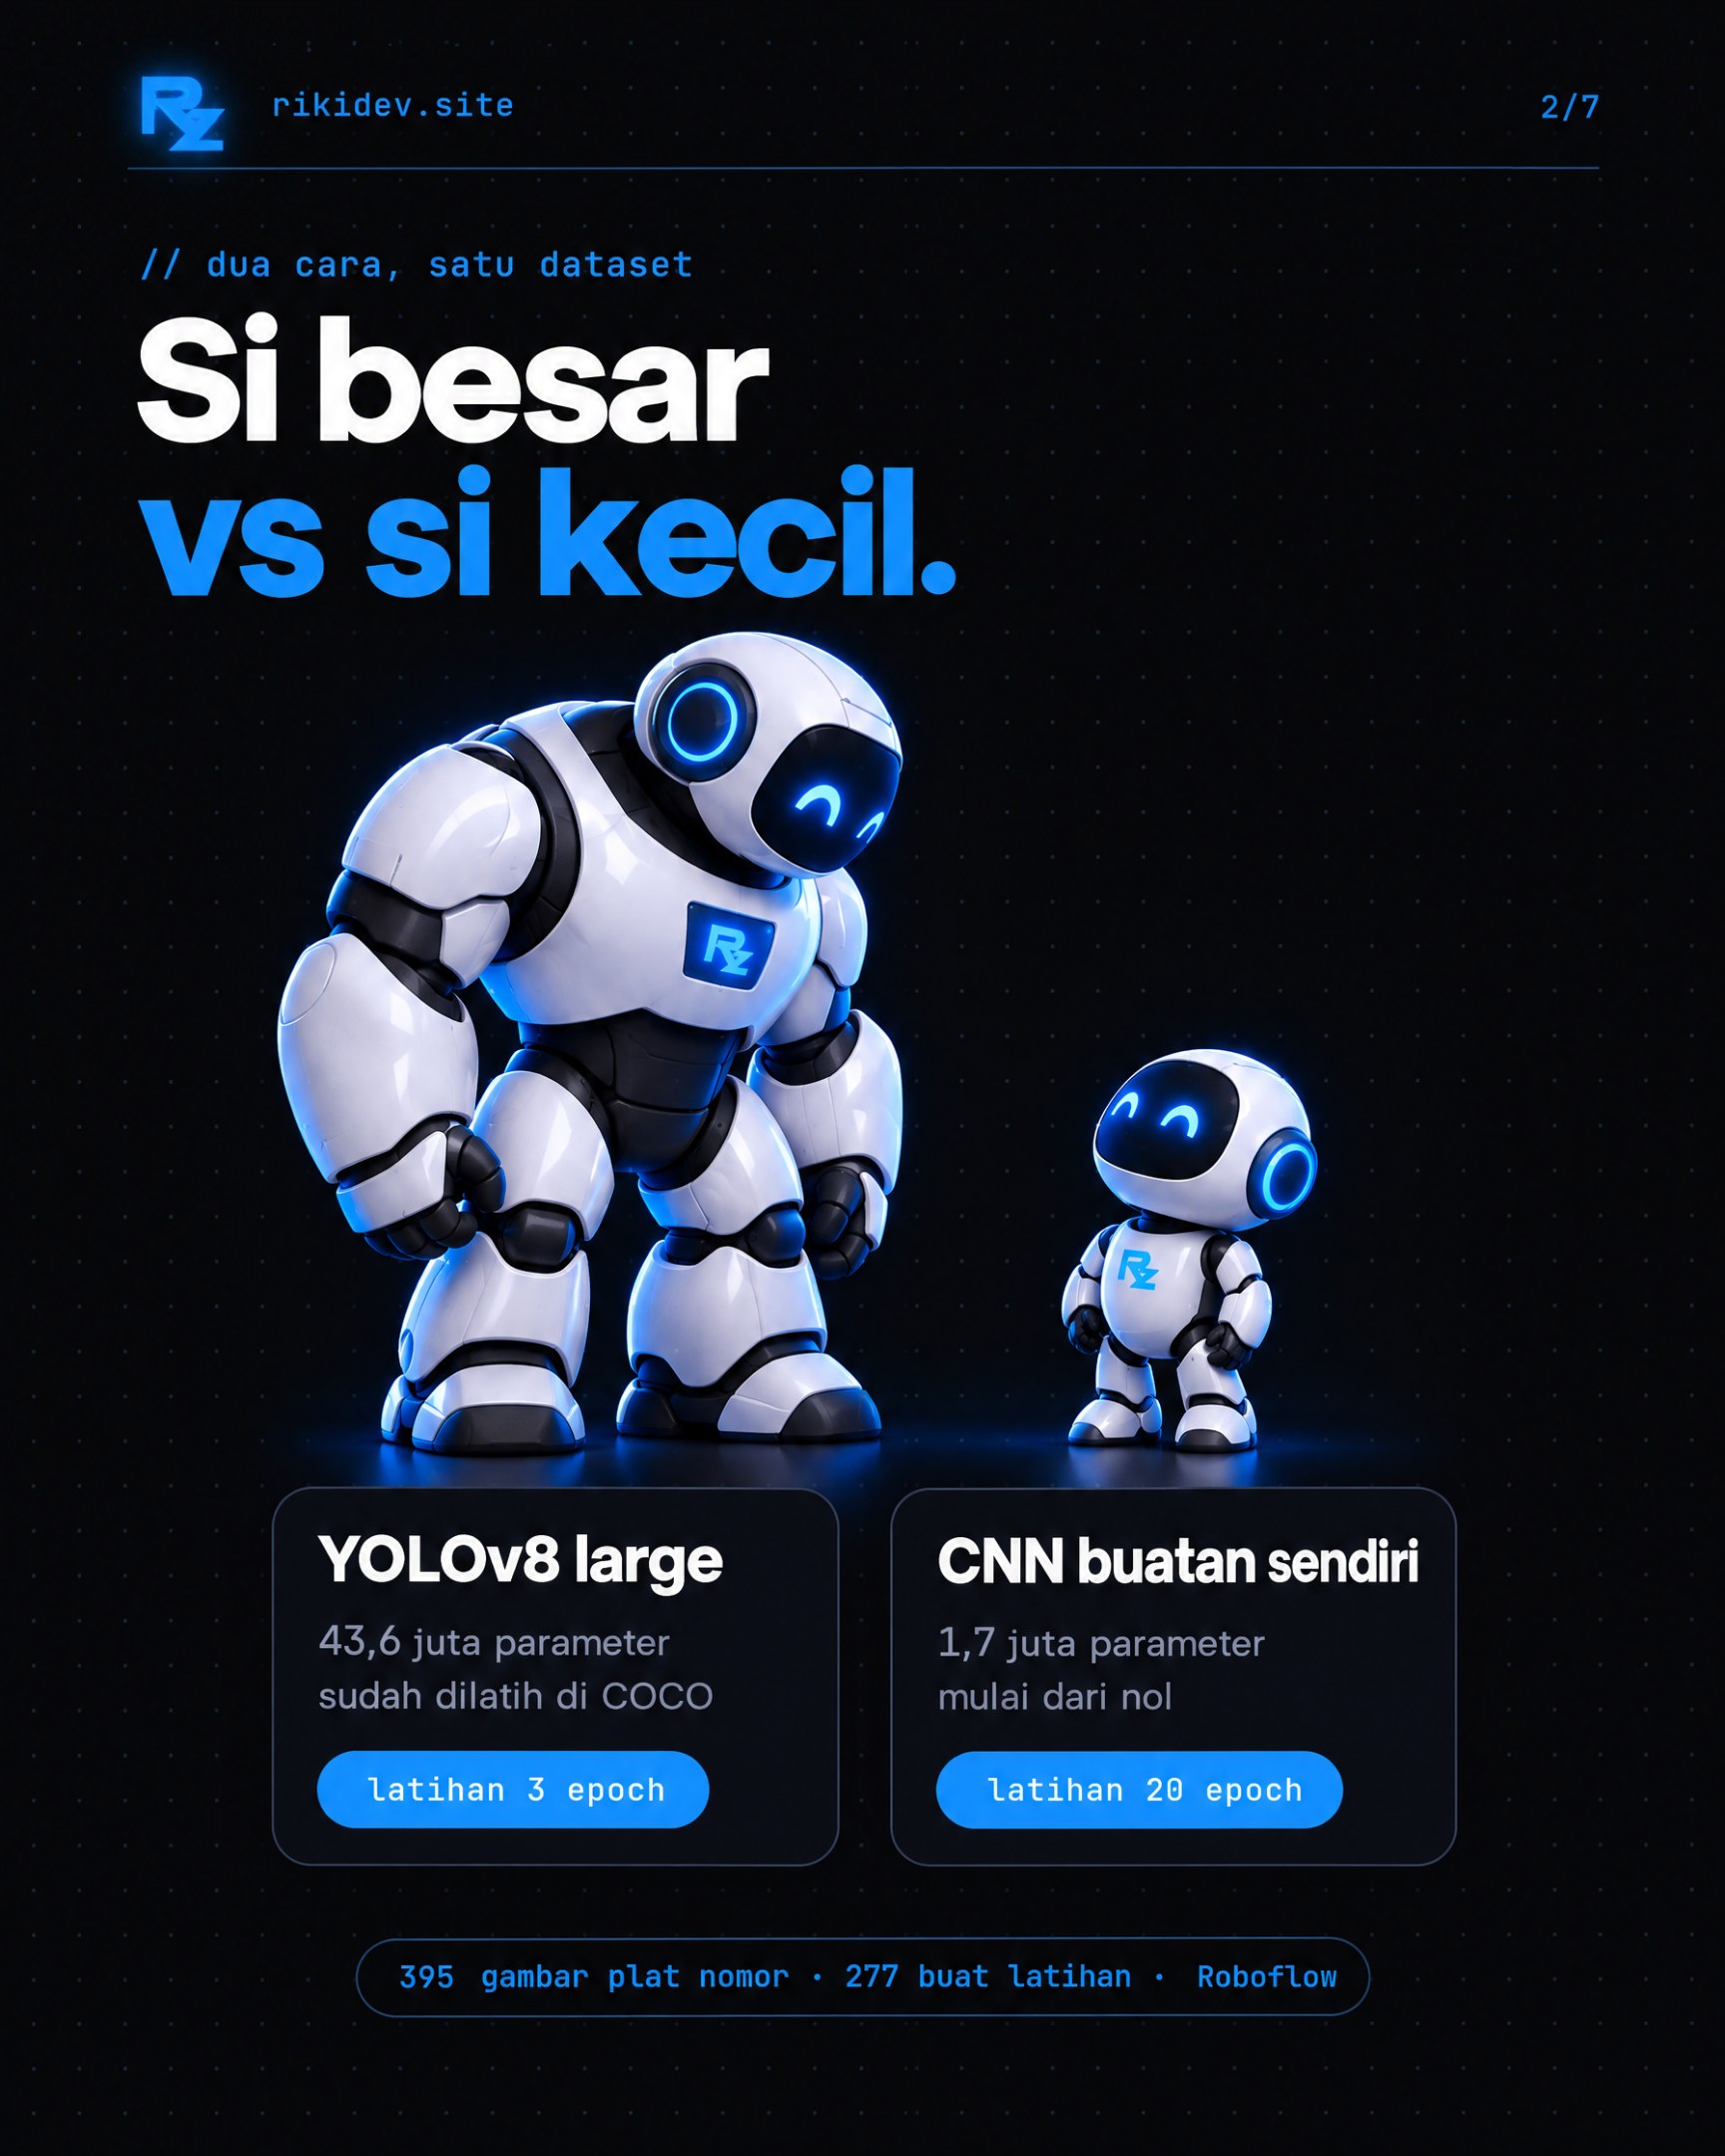
Dataset yang aku gunakan bersumber dari proyek Roboflow bernama license-plate-detector yang diunduh dalam format YOLOv8. Totalnya ada 395 gambar dengan rincian 277 gambar untuk train, 81 gambar untuk validation, dan 37 gambar untuk test. Ukuran asli gambarnya adalah 640 kali 640 piksel dengan satu kelas target yaitu license_plate. File konfigurasi data.yaml mendefinisikan lokasi folder train, val, dan test beserta jumlah kelasnya. Format label YOLO menyimpan informasi setiap objek dalam file teks terpisah di mana setiap baris berisi kelas, titik tengah x, titik tengah y, lebar, serta tinggi kotak. Semua angka tersebut dinormalisasi dari nol sampai satu terhadap ukuran gambar. Kita bisa mengubah nilai normalisasi ini kembali ke piksel dengan mengalikannya dengan ukuran gambar.
#Cara Pertama Menggunakan YOLOv8
Pada metode pertama, aku menggunakan model transfer learning dengan bobot pretrained COCO yaitu YOLOv8 large yang memiliki sekitar 43,6 juta parameter. Pengaturan training diset dengan jumlah epoch yang sangat singkat yaitu tiga epoch, ukuran gambar 416, batch size 16, dan patience 10 di lingkungan Google Colab menggunakan GPU Tesla T4. Hasil evaluasi pada 81 gambar validasi menunjukkan angka precision 0,0657, recall 0,519, mAP50 0,0605, dan mAP50-95 sebesar 0,0355. Gejala utamanya sangat jelas ketika satu gambar test menghasilkan 31 kotak plat nomor sekaligus padahal aslinya cuma ada satu. Hal ini terjadi karena model berukuran besar dengan 43,6 juta parameter hanya dilatih selama tiga epoch pada 277 gambar, membuat model menjadi undertrained dan menghasilkan banyak kotak acak dengan precision yang sangat rendah. Solusinya tentu dengan melatih model lebih lama sekitar 50 sampai 100 epoch atau memakai varian model yang lebih kecil.
#Cara Kedua Membangun CNN dari Nol
Sebagai perbandingan, cara kedua menggunakan pendekatan single object regression dengan membangun CNN dari nol yang hanya menebak satu kotak per objek per gambar. Arsitektur model ini memiliki 1.735.429 parameter yang terdiri dari beberapa lapisan konvolusi, batch normalization, ReLU, max pooling, adaptive average pool, serta lapisan linear di bagian akhir dengan dropout. Output dari model ini adalah lima nilai yang merepresentasikan posisi x, titik y, lebar w, tinggi h, dan tingkat keyakinan atau confidence. Fungsi loss yang dipakai adalah kombinasi Mean Squared Error untuk koordinat kotak dan Binary Cross Entropy untuk nilai confidence dengan bobot 0,5 tanpa loss kelas karena hanya ada satu kelas tunggal.
#Proses Training dan Evaluasi CNN
Model CNN buatan sendiri ini dilatih selama 20 epoch dengan batch size 16 menggunakan optimizer Adam pada learning rate 0,001. Aku juga menyertakan scheduler ReduceLROnPlateau yang akan mengurangi learning rate setengahnya jika validation loss tidak membaik selama lima epoch, serta gradient clipping dengan max norm 1,0 untuk mencegah gradien meledak. Berdasarkan kurva loss yang tercatat, validation loss turun drastis dari 0,0284 pada epoch pertama menjadi 0,0147 pada epoch kelima. Nilai validation loss terbaik tercatat sebesar 0,0133 pada epoch ke-12 sebelum akhirnya sedikit naik ke 0,0140 di akhir epoch ke-20 dengan train loss akhir 0,0179.
#Penutup
Eksperimen ini memberikan pelajaran penting tentang pentingnya menyesuaikan kapasitas model dan durasi training dengan ukuran dataset. Model sebesar YOLOv8 jelas memerlukan epoch yang jauh lebih banyak atau model yang lebih kecil agar bisa konvergen dengan baik pada dataset kecil. Sementara itu, CNN dari nol memberikan pemahaman mendalam tentang bagaimana loss function bekerja pada tingkat koordinat kotak untuk kasus deteksi objek tunggal.