PyTorch vs Keras untuk CNN: Perbedaan utama ada di perhitungan dimensi saat Flatten.
Membandingkan cara kerja Keras dan PyTorch dalam mengolah layer CNN untuk klasifikasi digit MNIST, khususnya perbedaan penanganan pada tahap Flatten.
Belajar Deep Learning sering kali membuat kita membandingkan dua framework populer, Keras dan PyTorch. Kali ini aku mencoba melatih CNN untuk klasifikasi digit MNIST menggunakan kedua framework tersebut di dalam satu notebook. Tujuannya bukan mencari mana yang paling hebat, melainkan memahami perbedaan mendasar cara kerja keduanya. Perbandingan ini membantuku melihat bagian mana yang benar-benar inti seperti arsitektur, loss, dan optimizer, serta mana yang sekadar beda gaya penulisan, terutama pada tahap Flatten yang punya penanganan dimensi berbeda.
#Persiapan Data dan Normalisasi MNIST
Dataset yang dipakai adalah MNIST asli berupa gambar 28x28 piksel dengan skala 0 sampai 255. Pada bagian Keras, langkah awalnya adalah memuat data lalu melakukan normalisasi dengan membagi nilai piksel dengan 255.0. Tujuannya mengubah nilai integer 0-255 menjadi float 0.0 hingga 1.0. Tanpa langkah ini, proses training akan jauh lebih lambat konvergen dan kadang tidak stabil karena skala input yang terlalu besar. Selain itu, aku menambahkan satu dimensi di akhir menggunakan tf.newaxis agar bentuk datanya berubah dari (jumlah, 28, 28) menjadi (jumlah, 28, 28, 1). Layer Conv2D di Keras mewajibkan input memiliki dimensi channel, satu untuk grayscale atau tiga untuk RGB, meskipun gambar kita hitam-putih.
#Arsitektur dan Training di Keras
Setelah data siap, aku menyusun arsitektur CNN menggunakan model Sequential di Keras. Di sini aku memakai dua layer konvolusi, max pooling, flatten, dan dua layer dense.
model = models.Sequential([
    layers.Conv2D(32, (3, 3), activation='relu', input_shape=(28, 28, 1)),
    layers.MaxPooling2D((2, 2)),
    layers.Conv2D(64, (3, 3), activation='relu'),
    layers.Flatten(),
    layers.Dense(64, activation='relu'),
    layers.Dense(10, activation='softmax')
])
model.compile(optimizer='adam', loss='sparse_categorical_crossentropy', metrics=['accuracy'])
Setiap layer memiliki fungsi spesifik. Conv2D dengan 32 filter ukuran 3x3 mendeteksi pola visual seperti tepi dan lengkungan. MaxPooling2D memperkecil ukuran spasial lewat downsampling untuk mengurangi komputasi. Layer Conv2D kedua menangkap pola yang lebih kompleks. Bagian penting berikutnya adalah Flatten(), yang mengubah output berdimensi dua atau tiga menjadi satu vektor panjang agar bisa masuk ke layer Dense. Untuk fungsi loss, aku memakai sparsecategoricalcrossentropy karena label data masih berupa angka integer dari nol sampai sembilan, bukan one-hot encoding. Training dijalankan selama 5 epoch dengan batch size 128 dan data validasi untuk memantau overfitting. Hasilnya, akurasi training naik dari 94.9 persen ke 99.3 persen, sementara akurasi validasi stabil di sekitar 98.9 persen.
#Perbedaan Perhitungan Flatten di PyTorch
Bagian selanjutnya di notebook adalah melatih CNN yang secara konsep setara, tetapi ditulis manual menggunakan PyTorch.
class SimpleCNN(nn.Module):
    def __init__(self):
        super().__init__()
        self.main = nn.Sequential(
            nn.Conv2d(1, 16, 3), nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Flatten(),
            nn.Linear(16 * 13 * 13, 10)
        )
    def forward(self, x): return self.main(x)
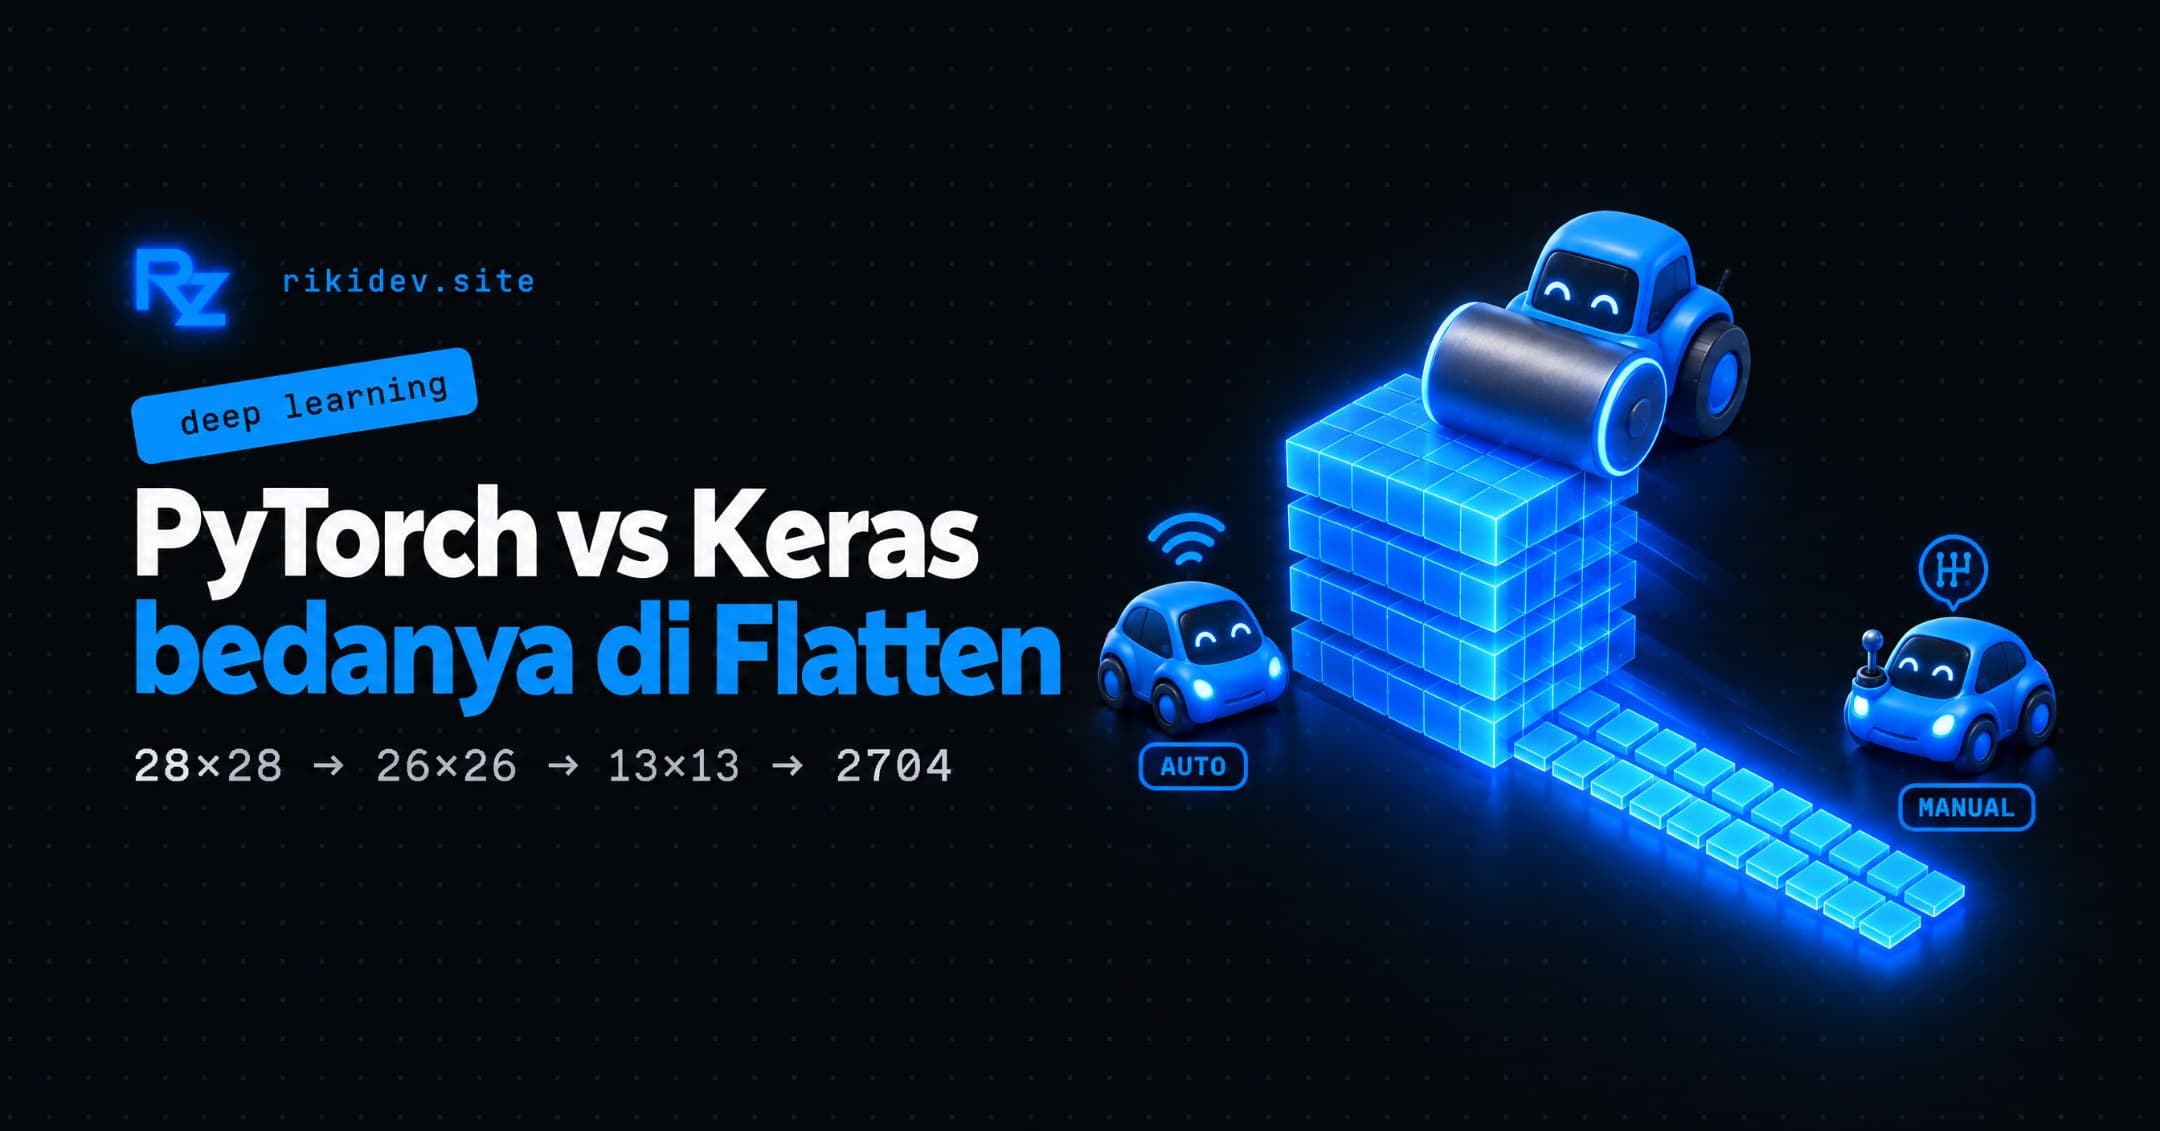
Meskipun arsiteksturnya sedikit lebih sederhana dengan satu layer konvolusi, ada satu perbedaan mencolok dibanding Keras. PyTorch tidak otomatis menghitung ukuran input untuk layer Linear setelah proses Flatten. Aku harus menghitungnya sendiri secara manual. Input awalnya adalah 28x28. Setelah melewati Conv2d dengan kernel 3 tanpa padding, ukurannya menjadi 28 dikurangi 3 ditambah 1, yaitu 26x26. Kemudian MaxPool2d dengan ukuran 2 membaginya menjadi 13x13. Karena jumlah channel dari Conv2d pertama adalah 16, total fitur flatten menjadi 16 dikali 13 dikali 13, yaitu 2704. Nilai inilah yang harus dimasukkan secara manual ke parameter pertama nn.Linear.
#Penutup
Membandingkan Keras dan PyTorch secara langsung memberiku wawasan berharga tentang cara kerja internal framework deep learning. Keras sangat memanjakan developer karena layer Flatten() secara otomatis menyesuaikan ukuran tensor tanpa perlu rumus manual. Sebaliknya, PyTorch menuntut ketelitian kita dalam menghitung dimensi tensor di setiap tahapan konvolusi dan pooling sebelum masuk ke fully connected layer. Kedua pendekatan ini sah, tinggal disesuaikan dengan kebutuhan eksplorasi dan kontrol yang kita inginkan dalam membangun model.